暖金与炭灰色的颗粒沿弧线逐渐汇聚成清晰的几何结构,表现从噪声到秩序的过程

Score-based Generative Models

真正意义的“扩散”模型,从梯度角度理解加噪去噪

GO UP! Diffusion + RL学习 03

宋飏大佬真的太强了,后续的 score-based SDE 更是无敌。

PAPER · YANG SONG & STEFANO ERMONGenerative Modeling by Estimating Gradients of the Data DistributionNeurIPS 2019 · arXiv:1907.05600 ↗

这篇文章也让我感到学数学物理的是真的强。Score-based Generative Models 从粒子扩散和梯度场的角度,让我重新理解了图像生成:一张图片可以看成高维空间中的一个点,而大量图片共同对应一个数据分布。

前向过程通过加噪,构造出一系列更平滑的分布;训练时,我们学习这些分布的梯度方向。生成时,再利用学到的梯度,从一个容易采样的初始分布逐步走向数据分布,也就是从 Prior 到 pdatap_{\mathrm{data}} 的过程。

对一个固定的干净样本来说,加噪后的条件分布的梯度,确实指向它的均值,而且可以证明这个方向与噪声相反。下面就沿着这条线,理解加噪、去噪和采样。

#Score 概念

先把概率密度写成能量模型(玻尔兹曼分布)的形式:

pθ(x)=e−fθ(x)Zθ,Zθ=∫e−fθ(x) dx.p_\theta(x)=\frac{e^{-f_\theta(x)}}{Z_\theta},\qquad Z_\theta=\int e^{-f_\theta(x)}\,\mathrm{d}x.

这里 fθ(x)f_\theta(x) 是能量函数,ZθZ_\theta 是归一化因子。我们关心的 score 是对数概率密度关于输入的梯度:

sθ(x)=∇xlog⁡pθ(x)=−∇xfθ(x)−∇xlog⁡Zθ⏟= 0=−∇xfθ(x).\begin{aligned}s_\theta(x)&=\nabla_x\log p_\theta(x)\\&=-\nabla_x f_\theta(x)-\underbrace{\nabla_x\log Z_\theta}_{=\,0}\\&=-\nabla_x f_\theta(x).\end{aligned}

这样一来,不好求的归一化因子就消失了,因为它不依赖于 xx。直观上,score 告诉我们:从当前位置出发,往哪个方向走,概率密度增长得最快。后面的 NCSN 会直接用网络拟合这个向量场。

与 DDPM 中噪声的关系

DDPM 的前向加噪可以写成:

q(xt∣x0)=N ⁣(xt;αˉt x0,(1−αˉt)I),xt=αˉt x0+1−αˉt ϵ,ϵ∼N(0,I),αˉt=∏s=1tαs,αs=1−βs.\begin{gathered}q(x_t\mid x_0)=\mathcal N\!\left(x_t;\sqrt{\bar\alpha_t}\,x_0,(1-\bar\alpha_t)I\right),\\x_t=\sqrt{\bar\alpha_t}\,x_0+\sqrt{1-\bar\alpha_t}\,\epsilon,\quad\epsilon\sim\mathcal N(0,I),\\\bar\alpha_t=\prod_{s=1}^{t}\alpha_s,\qquad\alpha_s=1-\beta_s.\end{gathered}

对这个条件高斯分布取对数,再对 xtx_t 求梯度:

∇xtlog⁡q(xt∣x0)=−xt−αˉt x01−αˉt=−ϵ1−αˉt.\begin{aligned}\nabla_{x_t}\log q(x_t\mid x_0)&=-\frac{x_t-\sqrt{\bar\alpha_t}\,x_0}{1-\bar\alpha_t}\\&=-\frac{\epsilon}{\sqrt{1-\bar\alpha_t}}.\end{aligned}

这里可以看到:条件 score 就是噪声的反方向,二者差一个标准差的系数。因此,噪声预测网络也可以换一种参数化方式,表示为 score 网络:

sθ(xt,t)=−ϵθ(xt,t)1−αˉt.s_\theta(x_t,t)=-\frac{\epsilon_\theta(x_t,t)}{\sqrt{1-\bar\alpha_t}}.

把前面的条件 score 公式移项,DDPM 的加噪关系也可以这样写:

xt=αˉt x0−(1−αˉt)∇xtlog⁡q(xt∣x0).x_t=\sqrt{\bar\alpha_t}\,x_0-(1-\bar\alpha_t)\nabla_{x_t}\log q(x_t\mid x_0).

#Score Matching 构建梯度场

与 flow matching 中拟合向量场的形式相似,score matching 也采用平方误差来学习一个向量场。但问题是:真实分布的 score 求不出来。一个经典操作就是加上条件,把不可计算的目标换成可以直接计算的高斯条件 score。

从加噪的条件分布出发

这里改用原论文的加性高斯噪声记法。设干净样本为 x0∼pdatax_0\sim p_{\mathrm{data}},噪声尺度为 σ>0\sigma>0:

x~=x0+σϵ,ϵ∼N(0,I).\tilde x=x_0+\sigma\epsilon,\qquad\epsilon\sim\mathcal N(0,I).
qσ(x~∣x0)=1(2πσ2)d/2exp⁡ ⁣(−∥x~−x0∥222σ2),qσ(x~)=∫qσ(x~∣x0)pdata(x0) dx0.\begin{aligned}q_\sigma(\tilde x\mid x_0)&=\frac{1}{(2\pi\sigma^2)^{d/2}}\exp\!\left(-\frac{\|\tilde x-x_0\|_2^2}{2\sigma^2}\right),\\q_\sigma(\tilde x)&=\int q_\sigma(\tilde x\mid x_0)p_{\mathrm{data}}(x_0)\,\mathrm{d}x_0.\end{aligned}

dd 是样本维度。条件分布的梯度容易计算:

∇x~log⁡qσ(x~∣x0)=−x~−x0σ2=−ϵσ.\begin{aligned}\nabla_{\tilde x}\log q_\sigma(\tilde x\mid x_0)&=-\frac{\tilde x-x_0}{\sigma^2}\\&=-\frac{\epsilon}{\sigma}.\end{aligned}

这里也进一步证明了:对于固定的 x0x_0,条件 score 是噪声的反方向。

为什么加条件后可以训练?

我们本来希望最小化的是:

JSM(θ;σ)=12Ex~∼qσ ⁣[∥sθ(x~,σ)−∇x~log⁡qσ(x~)∥22].\mathcal J_{\mathrm{SM}}(\theta;\sigma)=\frac12\mathbb E_{\tilde x\sim q_\sigma}\!\left[\left\|s_\theta(\tilde x,\sigma)-\nabla_{\tilde x}\log q_\sigma(\tilde x)\right\|_2^2\right].

把整体分布的 score 换成条件 score,就得到 Denoising Score Matching(DSM):

ℓ(θ;σ)=12Ex0,x~ ⁣[∥sθ(x~,σ)−∇x~log⁡qσ(x~∣x0)∥22]=12Ex0,ϵ ⁣[∥sθ(x0+σϵ,σ)+ϵσ∥22].\begin{aligned}\ell(\theta;\sigma)&=\frac12\mathbb E_{x_0,\tilde x}\!\left[\left\|s_\theta(\tilde x,\sigma)-\nabla_{\tilde x}\log q_\sigma(\tilde x\mid x_0)\right\|_2^2\right]\\&=\frac12\mathbb E_{x_0,\epsilon}\!\left[\left\|s_\theta(x_0+\sigma\epsilon,\sigma)+\frac{\epsilon}{\sigma}\right\|_2^2\right].\end{aligned}

两者只相差一个与模型参数 θ\theta 无关的常数,所以它们对训练的优化目标是等价的:

ℓ(θ;σ)=JSM(θ;σ)+Cσ.\ell(\theta;\sigma)=\mathcal J_{\mathrm{SM}}(\theta;\sigma)+C_\sigma.
展开推导:这个常数从哪里来?

记条件 score 为 u=∇x~log⁡qσ(x~∣x0)u=\nabla_{\tilde x}\log q_\sigma(\tilde x\mid x_0)。在通常的可微与可积条件下:

E[u∣x~]=∫pdata(x0)∇x~qσ(x~∣x0) dx0qσ(x~)=∇x~qσ(x~)qσ(x~)=∇x~log⁡qσ(x~).\begin{aligned}\mathbb E[u\mid\tilde x]&=\frac{\int p_{\mathrm{data}}(x_0)\nabla_{\tilde x}q_\sigma(\tilde x\mid x_0)\,\mathrm{d}x_0}{q_\sigma(\tilde x)}\\&=\frac{\nabla_{\tilde x}q_\sigma(\tilde x)}{q_\sigma(\tilde x)}=\nabla_{\tilde x}\log q_\sigma(\tilde x).\end{aligned}

把条件期望记作 uˉ\bar u,平方误差可分解为:

E∥sθ−u∥22=E∥sθ−uˉ∥22+E∥u−uˉ∥22.\mathbb E\|s_\theta-u\|_2^2=\mathbb E\|s_\theta-\bar u\|_2^2+\mathbb E\|u-\bar u\|_2^2.

交叉项为零,第二项不依赖于网络参数,这就是 2Cσ2C_\sigma。

延伸视频 · BILIBILI真正搞懂扩散模型 Score Matching 一定要理解的三大核心问题原文推荐的推导讲解 ↗

多个噪声尺度,一起学习

原论文选取一组从大到小的噪声尺度,并让同一个网络接收样本和噪声尺度两个输入:

σ1>σ2>⋯>σL>0,sθ(x~,σi)≈∇x~log⁡qσi(x~).\sigma_1>\sigma_2>\cdots>\sigma_L>0,\qquad s_\theta(\tilde x,\sigma_i)\approx\nabla_{\tilde x}\log q_{\sigma_i}(\tilde x).

使用权重 λ(σi)=σi2\lambda(\sigma_i)=\sigma_i^2,总损失为:

L(θ)=1L∑i=1Lσi2ℓ(θ;σi)=12L∑i=1LEx0,ϵ ⁣[∥σisθ(x0+σiϵ,σi)+ϵ∥22].\begin{aligned}\mathcal L(\theta)&=\frac1L\sum_{i=1}^L\sigma_i^2\ell(\theta;\sigma_i)\\&=\frac1{2L}\sum_{i=1}^L\mathbb E_{x_0,\epsilon}\!\left[\left\|\sigma_i s_\theta(x_0+\sigma_i\epsilon,\sigma_i)+\epsilon\right\|_2^2\right].\end{aligned}

这个加权有助于平衡不同噪声尺度下的训练目标。它并不意味着损失完全不依赖 σi\sigma_i,因为输入样本和网络的条件仍然随噪声尺度改变。

经过训练,我们希望得到类似下面这样的梯度场:
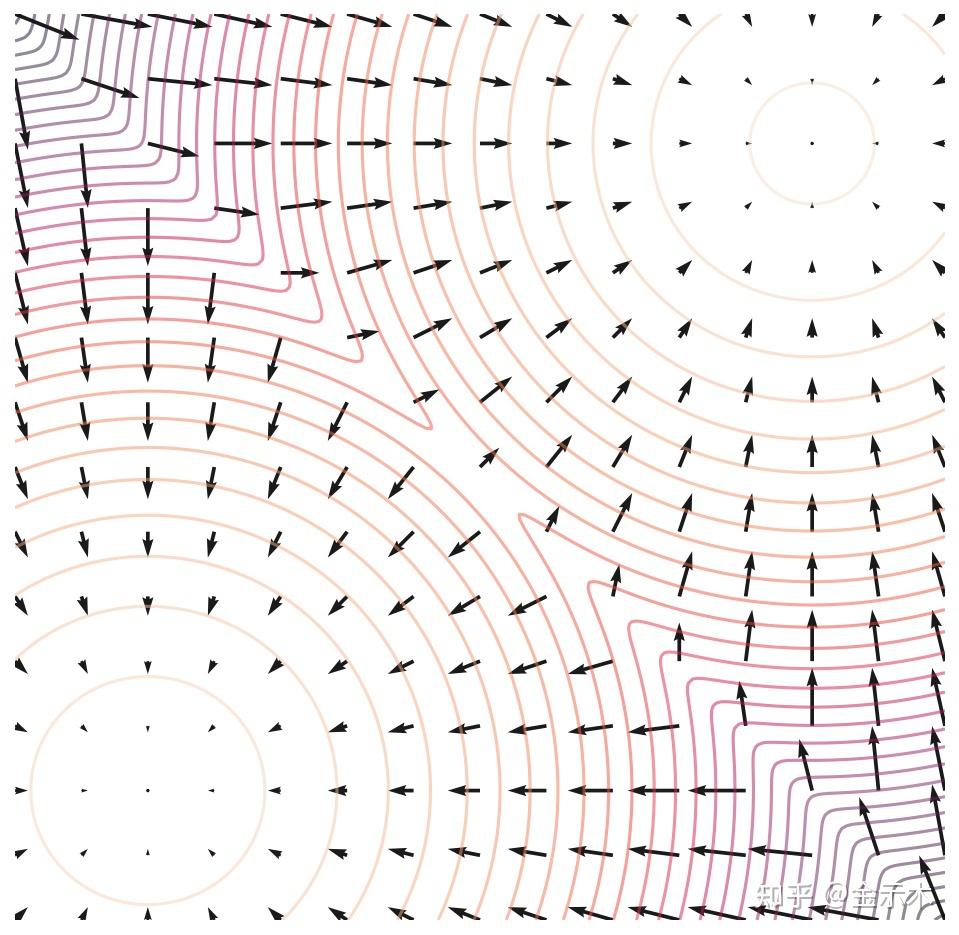
二维双峰分布的梯度场示意:箭头指向两个高概率密度区域,背景等高线表示密度
原文中的梯度场示意图。箭头表示局部概率密度增长的方向。

更准确地说,整体分布的 score 指向的是条件均值的方向,而不是指定的一张原图:

∇x~log⁡qσ(x~)=E[x0∣x~]−x~σ2.\nabla_{\tilde x}\log q_\sigma(\tilde x)=\frac{\mathbb E[x_0\mid\tilde x]-\tilde x}{\sigma^2}.

#Langevin dynamics 如何从 score 得到图像

有了梯度场,下一步就是采样。这里宋飏大佬借助了物理学中的朗之万动力学(Langevin dynamics):粒子一方面受到势能力和摩擦的影响,另一方面受到随机热噪声的扰动。

直观上,score 把样本推向高密度区域,随机扰动则让样本保持探索。两者一起作用,才是在采样一个分布,而不只是做梯度上升、最终停在某个峰值。

从粒子运动到采样公式

设势能为 U(x)U(x),温度为 TphysT_{\mathrm{phys}},玻尔兹曼常数为 kBk_B。平衡分布与势能力分别是:

peq(x)=1Zexp⁡ ⁣(−U(x)kBTphys),F(x)=−∇xU(x).p_{\mathrm{eq}}(x)=\frac1Z\exp\!\left(-\frac{U(x)}{k_BT_{\mathrm{phys}}}\right),\qquad F(x)=-\nabla_x U(x).

因此,力和 score 的关系为:

∇xlog⁡peq(x)=−∇xU(x)kBTphys=F(x)kBTphys.\nabla_x\log p_{\mathrm{eq}}(x)=-\frac{\nabla_x U(x)}{k_BT_{\mathrm{phys}}}=\frac{F(x)}{k_BT_{\mathrm{phys}}}.

包含惯性的朗之万方程写作:

dXt=Vt dt,m dVt=−γVt dt−∇U(Xt) dt+2γkBTphys dWt.\begin{aligned}\mathrm{d}X_t&=V_t\,\mathrm{d}t,\\m\,\mathrm{d}V_t&=-\gamma V_t\,\mathrm{d}t-\nabla U(X_t)\,\mathrm{d}t+\sqrt{2\gamma k_BT_{\mathrm{phys}}}\,\mathrm{d}W_t.\end{aligned}

其中 γ\gamma 是摩擦系数,WtW_t 是布朗运动。当惯性弛豫时间 m/γm/\gamma 远短于关注的时间尺度时,可以忽略惯性项,采用过阻尼近似:

dXt=−1γ∇U(Xt) dt+2kBTphysγ dWt=kBTphysγ∇log⁡peq(Xt) dt+2kBTphysγ dWt.\begin{aligned}\mathrm{d}X_t&=-\frac1\gamma\nabla U(X_t)\,\mathrm{d}t+\sqrt{\frac{2k_BT_{\mathrm{phys}}}{\gamma}}\,\mathrm{d}W_t\\&=\frac{k_BT_{\mathrm{phys}}}{\gamma}\nabla\log p_{\mathrm{eq}}(X_t)\,\mathrm{d}t+\sqrt{\frac{2k_BT_{\mathrm{phys}}}{\gamma}}\,\mathrm{d}W_t.\end{aligned}

离散化时,布朗运动的增量满足 ΔW∼N(0,Δt I)\Delta W\sim\mathcal N(0,\Delta t\,I)。令 η=2kBTphysΔt/γ\eta=2k_BT_{\mathrm{phys}}\Delta t/\gamma,就得到常见的采样形式:

Xn+1=Xn+η2∇log⁡p(Xn)+η zn,zn∼N(0,I).X_{n+1}=X_n+\frac\eta2\nabla\log p(X_n)+\sqrt\eta\,z_n,\qquad z_n\sim\mathcal N(0,I).

将真实 score 换成学习到的网络,就能用它来更新样本:

x~n+1=x~n+η2sθ(x~n,σ)+η zn.\tilde x_{n+1}=\tilde x_n+\frac\eta2s_\theta(\tilde x_n,\sigma)+\sqrt\eta\,z_n.

退火朗之万动力学采样

单一噪声尺度还不够。原论文从大噪声开始,逐级减小标准差,在每一级上执行若干次 Langevin 更新。这就是 Annealed Langevin Dynamics。

Algorithm 1 · Annealed Langevin Dynamics

输入:噪声序列 σ1>⋯>σL>0\sigma_1>\cdots>\sigma_L>0,最小噪声级的步长 ηmin⁡>0\eta_{\min}>0,每级迭代次数 KK。

  1. 从一个容易采样的初始分布取样,记为 x(0)x^{(0)}。
  2. 依次遍历 i=1,…,Li=1,\ldots,L,设置该级步长,对每个噪声级执行下面两步:
    ηi=ηmin⁡σi2σL2.\eta_i=\eta_{\min}\frac{\sigma_i^2}{\sigma_L^2}.
  3. 在第 ii 级内,重复 k=1,…,Kk=1,\ldots,K:
    zk∼N(0,I),x(k)=x(k−1)+ηi2sθ(x(k−1),σi)+ηi zk.\begin{aligned}z_k&\sim\mathcal N(0,I),\\x^{(k)}&=x^{(k-1)}+\frac{\eta_i}{2}s_\theta(x^{(k-1)},\sigma_i)+\sqrt{\eta_i}\,z_k.\end{aligned}
  4. 把当前输出传给下一个噪声级:x(0)←x(K)x^{(0)}\leftarrow x^{(K)};全部噪声级完成后返回最终样本。

这里的 ηmin⁡\eta_{\min} 对应原论文算法中的步长参数 ϵ\epsilon,KK 对应原算法的内循环次数 TT;换一组符号,是为了不和高斯噪声、物理温度混淆。

模型在每次更新时的输入,是上一步的样本和当前循环的标准差。每个噪声级的最后一个样本,作为下一级的初始样本。

pinit⟶qσ1⟶qσ2⟶⋯⟶qσL≈pdata.p_{\mathrm{init}}\longrightarrow q_{\sigma_1}\longrightarrow q_{\sigma_2}\longrightarrow\cdots\longrightarrow q_{\sigma_L}\approx p_{\mathrm{data}}.

这条路径表示采样逐步逼近不同噪声尺度的分布。大噪声级负责探索整体结构,小噪声级逐渐补上细节;步长与 σi2\sigma_i^2 成正比,随机项的幅度则与 σi\sigma_i 成正比。

#问题讨论

1. 流形假设

真实数据可能集中在高维空间中的低维流形附近。如果直接对这样的分布求 score,环境空间中的概率密度与梯度可能不好定义;远离数据的区域,也缺少足够的样本来学习可靠的方向。

加噪声有助于解决这个问题。高斯扰动把分布平滑到周围空间,让梯度更容易定义和学习;较大的噪声还能覆盖原始数据的低密度区域。

2. 标准差为什么要改变?

我的直观理解是:大的标准差用于“铺开”数据,增加覆盖范围;小的标准差用于最后逐步靠近真实数据。

  • 大标准差:平滑分布,帮助跨越低密度区域、探索不同模式,可以看成比简单数据增广更进一步的作用。
  • 小标准差:让加噪分布接近原始数据分布,在已有结构上逐步细化。

所以,这里的目标不是恢复某一张指定的 x0x_0,而是让最终生成的样本分布接近 pdatap_{\mathrm{data}}。从这个角度再看“加噪—去噪”,整个过程就连起来了。

#参考与延伸阅读

  1. Yang Song & Stefano Ermon. Generative Modeling by Estimating Gradients of the Data Distribution, NeurIPS 2019. Score Matching 与退火 Langevin 算法。
  2. Jonathan Ho, Ajay Jain & Pieter Abbeel. Denoising Diffusion Probabilistic Models, NeurIPS 2020. DDPM 加噪与噪声预测参数化。
  3. 真正搞懂扩散模型 Score Matching 一定要理解的三大核心问题,原文推荐视频。
  4. Hiba Assi et al. Disordered vortex matter out of equilibrium: a Langevin molecular dynamics study, 2015. 第 2.1–2.2 节,朗之万方程与涨落耗散关系的补充参考。